项目速览
- 行业:装备制造(集团 + 3 个厂区)
- 交付内容:文档采集与清洗、语义切分、向量检索 + 重排、权限过滤、问答前端、运营看板
- 周期:6 周出首个可用版本,之后 4 周迭代;团队 5 人
- 技术栈:内网 GPU 推理、开源 embedding 与重排模型、向量库、PHP 业务层与权限对接
背景:文档都在,但没人找得到
客户有 3,286 份制度、工艺、售后与合同类文档,散落在共享盘、OA 附件、老员工的本地文件夹里。新人问「备件保修多久」,答案通常是「问一下老李」。老李休假,问题就卡住。
客户一开始的期待很朴素:「做个搜索框」。我们先做了两件事:一是盘点文档(有多少份、什么格式、哪年的、谁维护),二是抽样 100 个真实问题看「标准答案在哪份文件第几条」。这两件事决定了后面所有设计。
关键设计
① 切分不是按字数,而是按语义结构
按 500 字硬切会把一条保修条款切成两半,检索到前半段时答案是不完整的。我们按标题层级、条款编号、表格单元切,并为每段保留「父级路径」(文档名 > 章节 > 子章节)作为上下文。仅这一项调整,抽样命中率从 61% 提升到 84%。
② 元数据决定检索质量
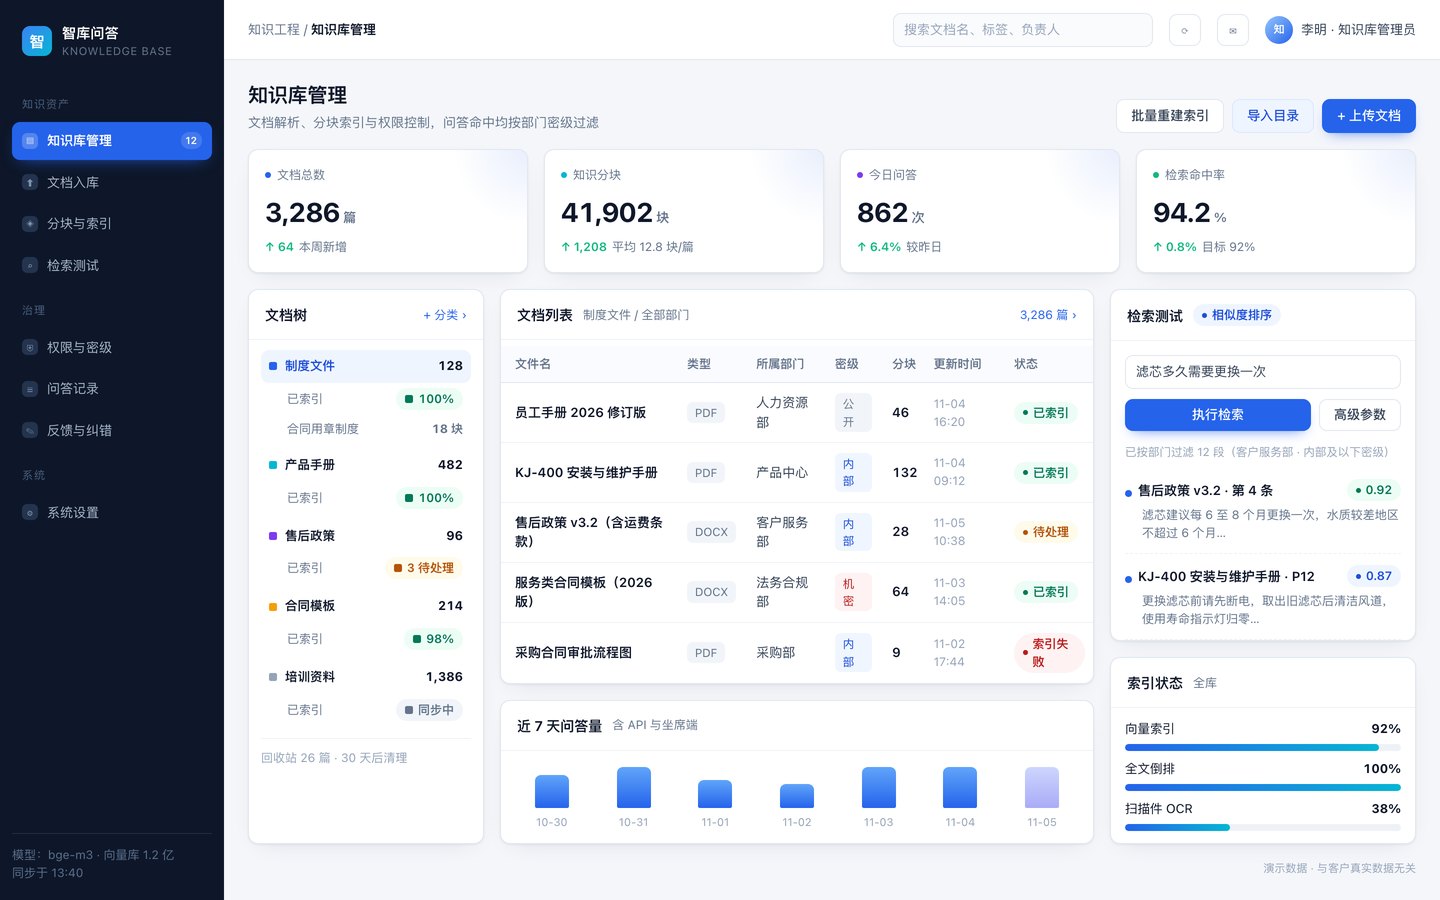
每段带部门、密级、生效日期、版本、文档类型五个字段,检索时先过滤再算相似度。这比换更大的 embedding 模型效果更明显——因为多数答错的原因是「检索到了不该给这个人看的旧版本」。
③ 权限在检索层过滤
权限沿用原有组织架构(部门 + 岗位 + 密级),在检索层过滤而不是靠提示词约束。测试期间我们特意用低权限账号试了 200 个问题,确认不会因为「模型知道」而泄露——这是甲方最在意的一条,也是验收的硬指标。
④ 回答必须带出处
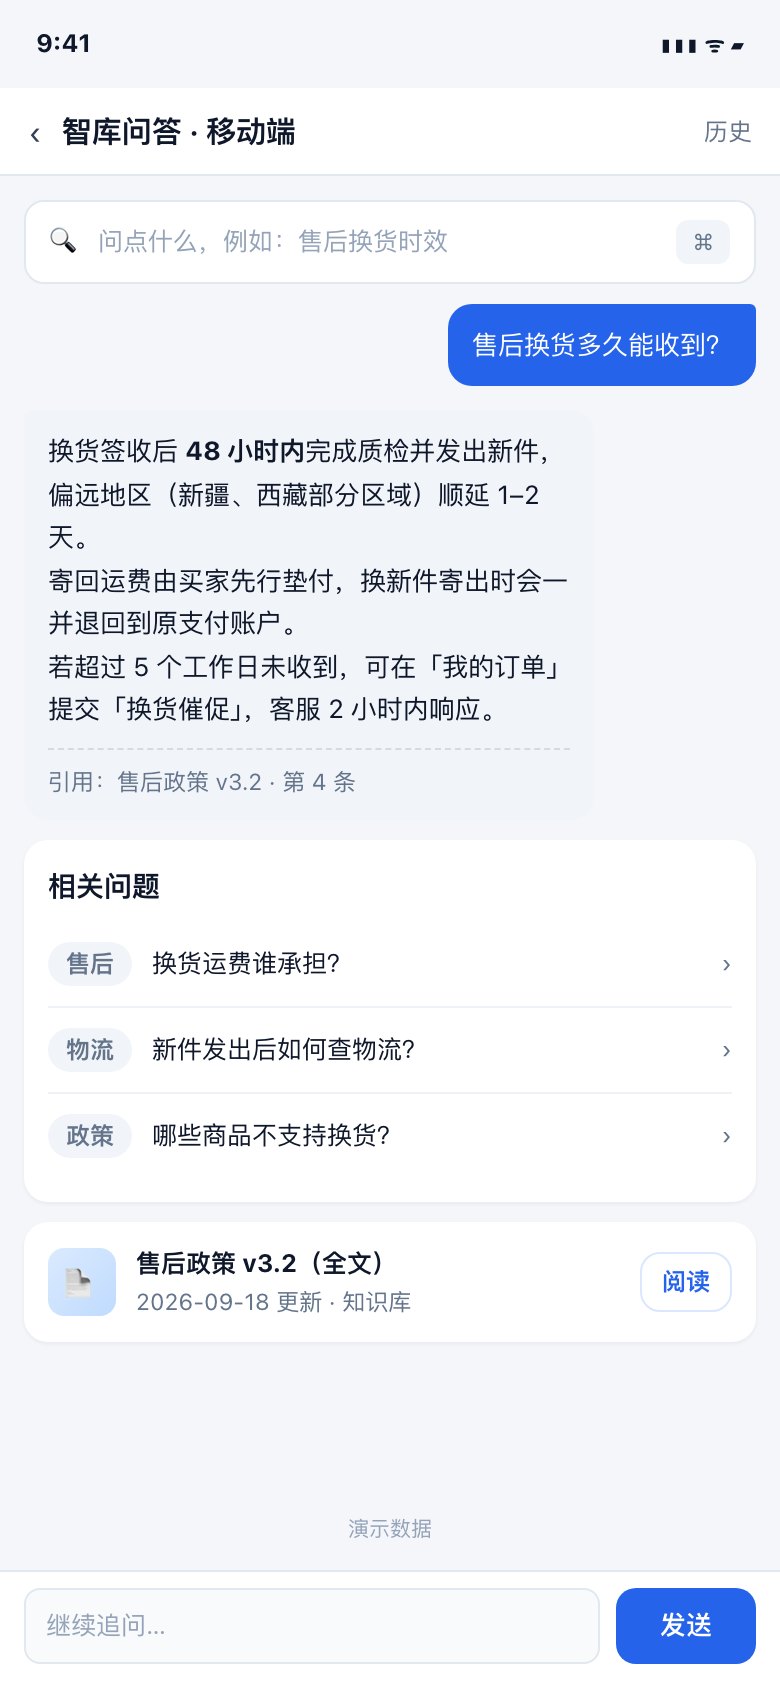
每个回答下面列出引用的文档名、章节与原文片段,点击可定位。业务同事的原话是:「我可以自己核对,才敢用」。没有出处的回答,即使是对的也不会被信任。
工程清单(这些才是工时去向)
- 文档清洗:扫描件 OCR、表格还原、页眉页脚去重、目录索引剔除,占总工时约 40%
- 增量更新:文档更新走「版本 + 生效日期」,旧版本标记失效但保留可查(追溯需要)
- 检索链路:向量召回 40 条 + 关键词召回 20 条 → 重排取前 5 条 → 生成,延迟控制在 2.5 秒内
- 评估机制:200 题内部评测集,每次调整切分或检索参数后重跑,看命中率与引用正确率
- 降级方案:模型服务不可用时退回「关键词检索 + 原文片段」模式,问答不中断
上线与推广
入口没有做成独立站点,而是嵌进 OA 与客服后台——知识库如果只能从独立页面进入,使用率一定低。第一周只开放给售后与新人培训两个场景,跑顺了再扩到全公司。
结果
新人查制度从「问老李」变成「问系统」,售后查保修条款从翻文档变成看回答加核对出处;文档治理第一次有了责任人(哪份文档长期没人更新,看板会列出来)。咨询量与培训时长的变化由客户掌握。
复盘
如果重做,我们会把「文档治理」作为独立阶段报价,而不是打包进「知识库建设」。客户在项目中期才意识到清洗工作占了近一半工时,虽然结果没受影响,但预算沟通上我们应该更早说清楚。
发表回复